引言
隨著邊緣計(jì)算的興起,將卷積神經(jīng)網(wǎng)絡(luò)(CNN)部署到資源受限的嵌入式設(shè)備成為關(guān)鍵挑戰(zhàn)。EdgeBoard作為一款面向邊緣AI的硬件平臺,為CNN推理提供了專門的加速架構(gòu)。本文將深入剖析EdgeBoard中CNN的實(shí)現(xiàn)機(jī)理,并探討其應(yīng)用軟件的設(shè)計(jì)與優(yōu)化策略。
EdgeBoard硬件平臺概述
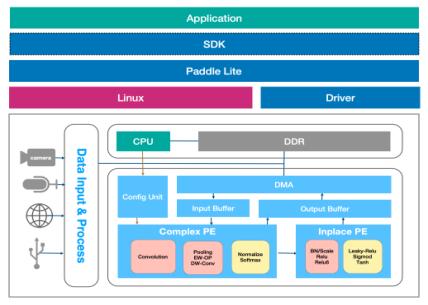
EdgeBoard通常基于Xilinx Zynq或類似SoC,集成了ARM處理器與FPGA。FPGA部分通過可編程邏輯實(shí)現(xiàn)CNN的并行計(jì)算單元,而ARM負(fù)責(zé)調(diào)度與后處理。這種異構(gòu)架構(gòu)使得CNN推理在低功耗下獲得高吞吐量。
CNN在EdgeBoard中的架構(gòu)需求
CNN的核心計(jì)算包括卷積、池化、激活等。傳統(tǒng)GPU功耗高,不適用于邊緣場景。EdgeBoard通過以下方式滿足需求:
- 定制化數(shù)據(jù)流:利用FPGA搭建脈動(dòng)陣列,實(shí)現(xiàn)權(quán)重與特征圖的流水線計(jì)算。
- 低位寬量化:將32位浮點(diǎn)量化為8位整數(shù)甚至二值,顯著減少存儲與帶寬。
- 層融合:將卷積、BN、ReLU合并,減少中間數(shù)據(jù)搬運(yùn)。
剖析EdgeBoard的CNN加速架構(gòu)
1. 計(jì)算單元設(shè)計(jì)
典型EdgeBoard CNN加速器包含PE陣列,每個(gè)PE執(zhí)行乘累加。通過權(quán)重固定或輸出固定數(shù)據(jù)流,靈活適配不同層。
2. 存儲層次
采用片上BRAM緩存權(quán)重和部分特征圖,減少DDR訪問。配合雙緩沖與乒乓操作,隱藏?cái)?shù)據(jù)傳輸延遲。
3. 控制流
由ARM端驅(qū)動(dòng)程序配置寄存器,指定卷積參數(shù)。硬件狀態(tài)機(jī)自動(dòng)遍歷輸入窗口,實(shí)現(xiàn)動(dòng)態(tài)調(diào)度。
典型CNN模型在EdgeBoard上的部署
以MobileNet為例,其深度可分離卷積非常適合EdgeBoard。部署步驟如下:
- 使用TensorFlow/PyTorch訓(xùn)練模型。
- 量化與剪枝,利用工具鏈轉(zhuǎn)換為FPGA可執(zhí)行的比特流。
- 將權(quán)重和指令編譯成二進(jìn)制文件,通過應(yīng)用軟件加載。
應(yīng)用軟件的設(shè)計(jì)
EdgeBoard應(yīng)用軟件需負(fù)責(zé)圖像采集、預(yù)處理、推理調(diào)度和后處理。典型架構(gòu)包括:
- 硬件抽象層:提供API控制加速器,如初始化、啟動(dòng)推理、等待完成。
- 任務(wù)調(diào)度:多線程處理視頻流,協(xié)調(diào)DMA傳輸與計(jì)算重疊。
- 后處理模塊:解析CNN輸出,執(zhí)行NMS、分類等,輸出最終結(jié)果。
性能優(yōu)化與實(shí)戰(zhàn)
為最大化EdgeBoard效能,需關(guān)注:
- 數(shù)據(jù)布局優(yōu)化:NHWC轉(zhuǎn)為NCHW或按塊排列,提升訪存效率。
- 算子融合:在軟件層將小算子合并成大算子,減少硬件調(diào)用開銷。
- 并行化:利用FPGA并行度同時(shí)處理多通道,ARM則多核并行運(yùn)行預(yù)處理。
與展望
EdgeBoard憑借靈活的CNN加速架構(gòu),在邊緣AI領(lǐng)域展現(xiàn)出強(qiáng)大潛力。通過軟硬件協(xié)同設(shè)計(jì),可顯著提升推理性能。隨著自動(dòng)搜索與編譯器技術(shù)的發(fā)展,CNN在EdgeBoard上的部署將更加便捷高效。